| Tunnistin | Valmistajan oma väite | Mitä siitä pitää tietää |
|---|---|---|
| GPTZero | 96,5 % tarkkuus, alle 1 % vääriä positiivisia siistillä tekstillä | Luku on valmistajan oma testi, ei riippumattoman tutkijan vahvistama |
| Turnitin | Alle 1 % vääriä positiivisia dokumenteissa, joissa tekoälyosuus yli 20 % | Turnitin on itse myöntänyt, että virheet kasautuvat tekstin ensimmäisiin ja viimeisiin lauseisiin |
| Copyleaks | Yli 99 % tarkkuus, 0,2 % vääriä positiivisia | Vain valmistajan oma julkaisema luku |
| Originality.ai | Yli 99 % tarkkuus | Vain valmistajan oma julkaisema luku |
| QuillBot, ZeroGPT | Ei julkista, todennettua menetelmäkuvausta | Liikkeellä olevat prosenttiluvut tulevat kolmansien osapuolten markkinointisivuilta, ei valmistajalta |
| OpenAI:n oma tunnistin (poistettu käytöstä) | – | Tunnisti oikein vain 26 % tekoälytekstistä ja merkitsi 9 % ihmisen kirjoittamasta tekstistä virheellisesti tekoälyksi. OpenAI veti työkalun pois heikon tarkkuuden vuoksi. |
Yksikään yllä olevista luvuista ei ole riippumattoman, vertaisarvioidun tutkimuksen vahvistama. Kun tutkijat ovat testanneet tunnistimia itse, tulokset ovat olleet selvästi huonompia kuin valmistajien markkinointi antaa ymmärtää – varsinkin, kun kirjoittaja ei ole äidinkielinen englannin puhuja.
Kuinka luotettavia tekoälytunnistimet ovat?
Eivät kovin luotettavia. Saksalais-latvialainen tutkimusryhmä testasi 14 yleisesti käytössä olevaa tunnistinta ja totesi, ettei yksikään niistä ollut samanaikaisesti tarkka ja luotettava; paraskin tunnistin menetti tarkkuuttaan heti, kun teksti oli käännetty tai kevyesti muokattu.
Vielä painavampi löytö koskee kirjoittajan kieltä. Stanfordin yliopiston tutkijat ajoivat seitsemän suosittua tunnistinta 91:n ei-äidinkielisen englannin puhujan kirjoittaman esseen läpi ja 88:n yhdysvaltalaisen kahdeksasluokkalaisen esseen läpi. Äidinkieliset esseet luokiteltiin oikein, mutta ei-äidinkielisten esseistä keskimäärin 61,3 % leimattiin virheellisesti tekoälyn kirjoittamiksi – yksi tunnistimista merkitsi peräti 97,8 % niistä tekoälyksi, ja kaikki seitsemän tunnistinta olivat yksimielisesti väärässä lähes joka viidennen esseen kohdalla. Tutkijat kehottivat suoraan olemaan käyttämättä tunnistimia arviointi- tai koulutuspäätösten perusteena. Tulos on tärkeä myös suomalaiselle lukijalle: sama vinouma koskee kaikkia, jotka kirjoittavat englanniksi vieraalla kielellä – esimerkiksi kansainvälisessä työssä tai opinnoissa.
Toinen tutkimusryhmä osoitti, että tunnistimen voi kiertää tarkoituksellisestikin. He rakensivat 11 miljardin parametrin uudelleenmuotoiluohjelman ja testasivat sillä useita tunnistimia, myös OpenAI:n omaa työkalua – yhden tunnistimen tarkkuus romahti 70,3 %:sta 4,6 %:iin, kun teksti muotoiltiin uudelleen ilman että sen asiasisältö muuttui. Jos tekstin voi kiertää tunnistimen ohi tarkoituksella, sen tulosta ei voi käyttää todisteena siitä, ettei tekstiä olisi kierretty.
Miten tunnistin ylipäätään yrittää arvata
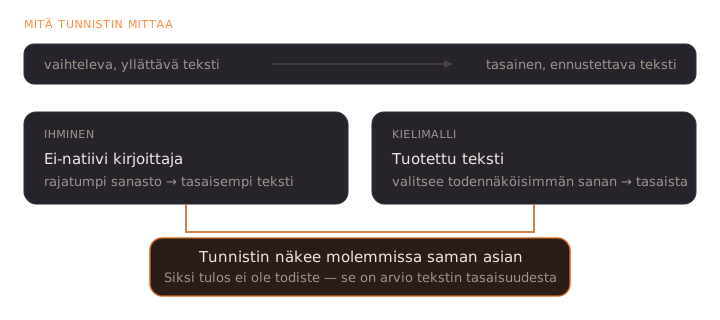
Useimmat tunnistimet eivät “tiedä” mikään teksti on tekoälyn kirjoittama – ne arvioivat tilastollisia vihjeitä, kuten kuinka ennustettavaa sanajärjestys on tai kuinka tasaisesti lauserakenne vaihtelee, ja vertaavat tekstiä siihen, miltä niiden opetusaineiston tekoälyteksti on näyttänyt. Tämä on arvaus todennäköisyyksien perusteella, ei tosiasioiden tarkistus – minkä vuoksi sama teksti voi saada eri tunnistimilta täysin eri tuloksen.
Vanhemmat menetelmät perustuivat lähinnä tekstin ennustettavuuteen ja lauseiden pituuden vaihteluun: ihmisen kirjoittama teksti “yllättää” tilastollisesti useammin kuin kielimallin tuottama. Uudemmat työkalut, kuten GPTZero, kertovat siirtyneensä koneoppimispohjaiseen luokittelijaan, joka on koulutettu suurella määrällä esimerkkitekstiä. Kummassakaan tapauksessa kyse ei ole tekstin alkuperän varmentamisesta vaan tilastollisesta arviosta, joka voi mennä pieleen kumpaankin suuntaan – ja jonka valmistaja ei koskaan avaa niin tarkasti, että ulkopuolinen voisi vahvistaa sen tarkkuuden riippumattomasti.
Voiko tunnistin erehtyä?
Kyllä, ja se tapahtuu useammin kuin valmistajat antavat ymmärtää. Selvin esimerkki tulee OpenAI:lta itseltään: yhtiö julkaisi oman tekoälytekstin tunnistimensa, mutta veti sen pois käytöstä puolen vuoden kuluttua, koska se tunnisti oikein vain 26 % oikeasti tekoälyn kirjoittamasta tekstistä ja merkitsi 9 % ihmisen kirjoittamasta tekstistä virheellisesti tekoälyksi. Työkalu oli lisäksi tunnetusti epäluotettava alle 1 000 merkin pituisilla teksteillä. Jos tekoälyn valmistaja itse ei onnistunut rakentamaan luotettavaa tunnistinta omalle mallilleen, se kertoo paljon koko tekniikan rajoista.
Journalistinen koe vahvistaa saman: yhdysvaltalainen sanomalehti teetätti viidellä lukiolaisella 16 tekstinäytettä – osan ihmisen, osan tekoälyn ja osan molempien kirjoittamana – ja ajoi ne Turnitinin tunnistimen läpi. Tunnistin arvioi väärin yli puolet näytteistä, mukaan lukien merkitsi osan oppilaan omasta, aidosta tekstistä tekoälyn kirjoittamaksi. Turnitin itse ilmoittaa oman testinsä perusteella, että virhemarginaali jää alle prosenttiin niissä dokumenteissa, joissa tekoälyosuus on yli 20 % – mutta on samalla julkisesti myöntänyt, että virheet kasautuvat erityisesti tekstin ensimmäisiin ja viimeisiin lauseisiin, ja muutti tämän vuoksi tapaa, jolla se laskee lauseiden yhteispisteet. Kahden yhtä aikaa julkaistun luvun – oman testin sub-1 %:n virhemarginaalin ja toimittajien käytännön kokeen “yli puolet väärin” -tuloksen – välinen ero kertoo, kuinka paljon lopputulos riippuu siitä, kuka testin tekee ja millä aineistolla.
Sekä väärä positiivinen (aito teksti leimataan tekoälyksi) että väärä negatiivinen (tekoälyteksti läpäisee tunnistimen) ovat siis todellisia, dokumentoituja riskejä – ei teoreettisia poikkeuksia. Kumpaakin virhettä voi tapahtua samalle tekstille eri tunnistimilla, mikä on hyvä syy olla luottamatta yhteen ainoaan tulokseen.
Tunnistaako opettaja tekoälytekstin?
Ei luotettavasti pelkän tunnistintyökalun avulla. Kaksi yhdysvaltalaista yliopistoa, jotka ovat julkaisseet asiasta virallisen kannan, kieltävät nimenomaisesti tunnistintuloksen käytön ainoana perusteena opiskelijaa vastaan. Toinen toteaa suoraan, ettei pelkkä epäily tekoälyn käytöstä riitä vastuun toteamiseen, eikä tunnistinta saa käyttää ainoana tukena kurinpitotapauksessa. Toinen ei suosittele tunnistintyökalujen käyttöä lainkaan arvioinnissa, koska ne eivät sen oman arvion mukaan osoita riittävää tarkkuutta tai läpinäkyvyyttä täyttääkseen näytön vaatimukset.
Suomalaisten oppilaitosten virallisia, julkisia linjauksia ei tätä sivua varten löytynyt, mutta samat luotettavuusongelmat pätevät kielestä riippumatta – ja ne koskevat erityisesti sinua, jos et kirjoita äidinkielelläsi tai jos käytät oikolukuohjelmaa, joka muotoilee lauseita uudelleen. Opettajan tai esimiehen kannalta järkevin lähtökohta on käyttää tunnistinta korkeintaan yhtenä havaintona monista, ei lopullisena tuomiona.
Muista tämä, jos joudut tunnistimen eteen
- Yksi tunnistintulos ei ole todiste sinänsä – ei edes valmistajien omien käyttöehtojen mukaan.
- Ei-äidinkielinen kirjoittaja on tutkitusti suuremmassa riskissä saada virheellinen “tekoäly”-tulos.
- Kevyesti muokattu, uudelleenmuotoiltu tai käännetty teksti läpäisee tunnistimen usein, vaikka se olisi kokonaan tekoälyn kirjoittama.
- Tunnistimen prosenttiluku (“87 % todennäköisesti tekoälyn kirjoittama”) kuulostaa täsmälliseltä, mutta perustuu tilastolliseen arvaukseen – ei se voi koskaan olla 100 % varma kummastakaan suunnasta.
- Jos joku vetoaa pelkkään tunnistintulokseen sinua vastaan, pyydä että päätös perustuu myös muuhun näyttöön – ei vain yhteen prosenttilukuun.
- Lue myös, mitä ei kannata kertoa tekoälylle ennen kuin syötät oman tai jonkun toisen tekstin tunnistintyökaluun – monet niistä tallentavat syötetyn tekstin.
Kannattaako tunnistinta ylipäätään käyttää?
Tunnistin voi olla yksi lähtökohta keskustelulle, mutta se ei koskaan riitä yksin. Jos epäilet, että teksti on kokonaan tekoälyn kirjoittama, hyödyllisempiä keinoja ovat esimerkiksi pyytää kirjoittajaa selittämään tekstin sisältöä omin sanoin, katsoa asiakirjan muokkaushistoriaa (jos sellainen on saatavilla), tai yksinkertaisesti keskustella asiasta suoraan. Kummatkin virallisen linjauksen julkaisseet yliopistot päätyivät samaan johtopäätökseen eri sanoin: tunnistin voi herättää epäilyn, mutta vastuun toteaminen vaatii aina muuta, vahvempaa näyttöä.
Tämä koskee myös työelämää. Jos yrityksesi harkitsee tunnistimen käyttöönottoa esimerkiksi rekrytoinnissa tai sisällöntuotannon valvonnassa, kannattaa tietää etukäteen, että yksikään markkinoilla oleva työkalu ei ole ulkopuolisen tahon riippumattomasti vahvistama luotettavaksi – ja että virhe osuu tutkitusti useammin ei-äidinkielisiin kirjoittajiin, mikä voi olla myös syrjivää kohtelua.
Lähteet
- GPTZero — Technology
- Turnitin — Understanding false positives within our AI writing detection capabilities
- Copyleaks blog — AI Detector Continues Top Accuracy in Third-Party Studies
- Originality.AI blog — AI Detector By Originality.ai Has 99%+ Accuracy
- OpenAI — New AI classifier for indicating AI-written text
- TechCrunch — OpenAI scuttles AI-written text detector
- Liang et al., “GPT detectors are biased against non-native English writers,” Patterns (Cell Press) 2023
- Weber-Wulff et al., “Testing of detection tools for AI-generated text,” International Journal for Educational Integrity 2023
- Krishna et al., “Paraphrasing evades detectors of AI-generated text,” NeurIPS 2023
- Washington Post — “We tested Turnitin’s ChatGPT-detector for teachers. It got some wrong.”
- Washington State University — Detecting and Reporting Misconduct Related to Generative AI
- University of North Florida — UNF’s Stance on AI Detection Tools
Usein kysyttyä
Voiko tekoälyllä kirjoitetun tekstin muokata niin, ettei tunnistin huomaa sitä?
Kyllä. Tutkijat rakensivat uudelleenmuotoiluohjelman, joka kiersi useita tunnistimia, myös OpenAI:n oman työkalun – yhden tunnistimen tarkkuus romahti 70 %:sta alle 5 %:iin samalla, kun teksti pysyi asiasisällöltään samana. Kevyt muokkaus tai kääntäminen toisesta kielestä heikentää tunnistustarkkuutta samalla tavalla.
Onko jokin tunnistin muita luotettavampi?
Ei ole riippumatonta näyttöä siitä, että mikään kaupallinen tunnistin olisi selvästi muita parempi. Valmistajien omat tarkkuusluvut eroavat usein rajusti riippumattomien tutkimusten tuloksista, eikä yksikään testatuista 14 työkalusta osoittautunut samanaikaisesti tarkaksi ja luotettavaksi.
Mitä kannattaa tehdä, jos tunnistin väittää virheellisesti tekstin olevan tekoälyn kirjoittama?
Vaadi, ettei pelkkä tunnistintulos riitä johtopäätökseksi. Yhdysvaltalaisyliopistot, jotka ovat julkaisseet virallisen linjauksen aiheesta, kieltävät nimenomaisesti tunnistimen käytön ainoana todisteena epäilyssä – sama periaate pätee riippumatta siitä, missä maassa tai kielellä teksti on kirjoitettu.