Kielimalli on luonnollisen kielen käsittelyssä käytettävä malli (Tietotekniikan termitalkoot), joka tuottaa vastauksensa ennustamalla todennäköisimmän seuraavan sanan opitun tilastollisen rakenteen perusteella — se ei hae vastausta valmiista sivusta niin kuin hakukone. Tämä yksi ero selittää suurimman osan siitä, miksi kielimalli toisinaan tuntuu maagisen hyvältä ja toisinaan tuottaa jotain, joka on täysin väärin mutta silti täysin sujuvaa: molemmat ovat saman mekanismin, sanasta sanaan -ennustamisen, kaksi eri lopputulosta.
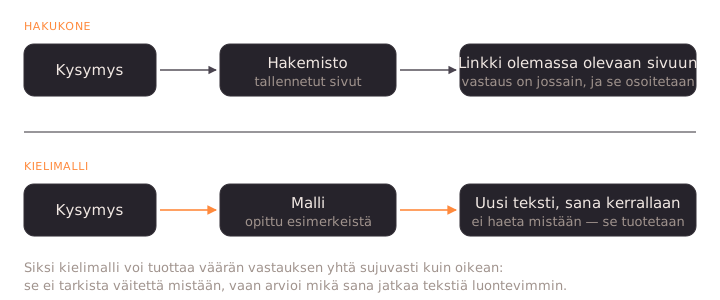
| Hakukone | Kielimalli | |
|---|---|---|
| Mistä vastaus tulee | Olemassa olevalta, jonkun ihmisen kirjoittamalta verkkosivulta | Mallin tuottamana, sana kerrallaan opitun tilastollisen rakenteen perusteella |
| Voiko jäljittää lähteen | Kyllä — tulos on linkki alkuperäiseen sivuun | Ei suoraan, ellei järjestelmään ole erikseen liitetty hakutoimintoa |
| Voiko olla väärässä | Kyllä, jos lähdesivu on virheellinen | Kyllä, myös silloin kun mikään lähdesivu ei ole virheellinen — malli voi silti hallusinoida |
| Tyypillinen käyttö | “Etsi tietoa jostain aiheesta” | “Selitä, tiivistä, kirjoita tai muotoile jokin asia” |
Taulukon rivit eivät tarkoita, että toinen olisi yleisesti parempi kuin toinen — ne ovat kaksi eri työkalua kahteen eri tehtävään. Hakukone on oikea valinta, kun tarvitset osoitteen, ajan tai muun tarkan, jäljitettävän tiedon johonkin olemassa olevaan sivuun. Kielimalli on oikea valinta, kun tarvitset jotain, mitä ei ole valmiiksi kirjoitettu missään — tiivistelmän, selityksen omin sanoin tai luonnoksen. Ongelma syntyy, kun käyttäjä olettaa kielimallin toimivan kuin hakukone: kysyy tarkkaa faktaa ja odottaa samaa luotettavuutta kuin linkiltä alkuperäiseen lähteeseen, vaikka kielimalli ei koskaan lupaa tätä.
Moni nykyinen hakukone on itsessään alkanut yhdistää molempia tapoja: hakutuloksen yläpuolelle voidaan näyttää kielimallin tuottama yhteenveto ennen varsinaisia linkkejä. Tämä ei poista eroa hakukoneen ja kielimallin välillä — se vain tuo kielimallin osaksi hakukokemusta. Yhteenveto on edelleen mallin tuottamaa, uutta tekstiä, ei suora lainaus mistään yksittäisestä sivusta, joten samat hallusinaatioriskit koskevat sitä siinä missä mitä tahansa muutakin kielimallin tuottamaa tekstiä — vaikka se näkyisikin hakutuloksen yhteydessä ja siksi tuntuisi yhtä luotettavalta kuin perinteinen hakutulos.
Mikä on suuri kielimalli?
“Suuri kielimalli” (large language model, LLM) on kielimalli, joka on koulutettu valtavalla määrällä tekstiä. TEPA-termipankki listaa suuren kielimallin kielimallin lähikäsitteeksi ilman erillistä omaa määritelmätekstiä, mutta itse kielimalli-termi on määritelty: malli perustuu joko koneelle opetettuihin kielioppisääntöihin tai — nykyisten suurten kielimallien tapauksessa — sanojen ja sanajonojen todennäköisyysjakaumiin, jotka on opittu suurista tekstiaineistoista. Käytännössä tämä tarkoittaa: malli on nähnyt koulutuksessa valtavan määrän tekstiä ja on oppinut siitä, mitkä sanat seuraavat toisiaan todennäköisimmin missäkin yhteydessä. Kun annat sille kehotteen, se ennustaa toistuvasti “mikä sana on todennäköisin seuraava” ja lisää sen vastaukseen, yksi tekstinpala (tokeni) kerrallaan, kunnes vastaus on valmis.
Mallilla ei ole erillistä tietokantaa, josta se “hakisi” faktan valmiina — jokainen vastaus rakennetaan uudelleen opittujen todennäköisyyksien pohjalta. Tästä seuraa käytännön ero hakukoneeseen: hakukone osoittaa sinulle olemassa olevan sivun, kielimalli kirjoittaa sinulle uuden tekstin, joka voi olla oikein, väärin tai jotain siltä väliltä, riippumatta siitä onko mikään yksittäinen lähde ollut virheellinen.
“Suuri” viittaa tässä nimenomaan koulutusdatan ja mallin sisäisen rakenteen kokoon, ei siihen, kuinka “fiksu” malli tuntuu käytössä. Kaksi eri kokoista kielimallia voivat molemmat olla teknisesti kielimalleja samalla TEPA-määritelmällä, mutta suurempi malli on tyypillisesti nähnyt koulutuksessa enemmän esimerkkejä useammasta aiheesta, mikä näkyy käytännössä laajempana kykynä käsitellä harvinaisempia aiheita sujuvasti.
Kielimalleja on ollut olemassa ennen suuria kielimallejakin — aiemmat, pienemmät kielimallit perustuivat usein koneelle opetettuihin kielioppisääntöihin sen sijaan, että ne olisivat oppineet todennäköisyysjakaumia valtavasta tekstiaineistosta. Nykyiset chatbotit, kuten ChatGPT, Gemini ja Claude, ovat kaikki nimenomaan suuria kielimalleja tässä jälkimmäisessä, tilastollisessa mielessä — ero vanhempiin sääntöpohjaisiin kielimalleihin on periaatteellinen, ei vain koon kysymys.
Miksi kielimalli erehtyy?
Koska sen tehtävä on nimenomaan sanasta sanaan -ennustaminen, ei tosiasioiden tarkistaminen. Kotus on kuvannut asian suoraan: “Tekoäly tarkoittaa käytännössä sanasta sanaan ennustamista, ja siksi se vaatii toimiakseen laadukkaan kielimallin… Tekoäly itsessään ei siis välttämättä tuota järkevää sisältöä, koska se perustuu vain todennäköisyyksiin.” Ilmiölle on suomenkielinen verbi, jonka Kotus otti sanapoimintoihinsa: hallusinoida — “tekoälyn toimintaa kuvaava verbi. Tekoäly hallusinoi, kun se vastaa sille osoitettuihin kehotteisiin tuottamalla epärealistisia tai järjettömiä vastauksia.” Malli ei siis tee tietoista virhettä, vaan tuottaa aina tilastollisesti todennäköisimmän jatkon riippumatta siitä, onko se totta.
Käytännön esimerkki havainnollistaa tätä hyvin: jos pyydät kielimallia antamaan lähdeviitteen tai tarkan lainauksen, se voi tuottaa täysin uskottavan näköisen otsikon, tekijän ja jopa sivunumeron — ilman että mitään tällaista lähdettä on koskaan olemassa. Tämä ei johdu siitä, että malli “valehtelisi”; se on vain tuottanut lähdeviitteen näköistä tekstiä samalla mekanismilla kuin minkä tahansa muunkin tekstin, koska sillä ei ole pääsyä mihinkään todelliseen lähdeluetteloon jota vasten tarkistaa väitteensä.
Osa järjestelmistä yhdistää kielimallin hakutoimintoon: malli hakee ensin oikeita, olemassa olevia dokumentteja ja muodostaa vastauksensa niiden pohjalta sen sijaan, että nojaisi pelkkään opittuun tilastoon. Tätä arkkitehtuuria kutsutaan RAG:ksi (Retrieval-Augmented Generation). Juuri tämä ero — hakeeko malli oikeasti dokumentin vai tuottaako se tekstin pelkästä opitusta kuviosta — on se, mikä erottaa hakuavusteisen kielimallin tavallisesta kielimallista, ja miksi RAG-järjestelmä pystyy tyypillisesti näyttämään lähteensä siinä missä tavallinen kielimalli ei. Monet nykyiset chatbotit yhdistävät molemmat tavat samassa tuotteessa: osa vastauksesta voi tulla suoraan verkkohausta lähteineen, osa mallin omasta, opitusta tilastollisesta rakenteesta ilman erillistä lähdettä — ja käyttöliittymä ei aina tee tätä eroa selväksi sinulle.
Esimerkki: näin teksti pilkotaan tokeneiksi
Kielimalli ei käsittele tekstiä kokonaisina sanoina, vaan pienempinä palasina, tokeneina. Lyhyt, yleinen sana muodostaa tyypillisesti yhden ainoan tokenin, kun taas pitkä tai harvinainen sana pilkotaan tyypillisesti useampaan tokeniin. Sana “kissa” voi olla yksi tokeni, kun taas pitkä yhdyssana kuten “kielenkääntäjäohjelmisto” voi jakautua useaan pienempään osaan, koska malli ei ole nähnyt koulutuksessa juuri tätä yhdyssanaa yhtä usein kokonaisena kuin sen osia erikseen. Tämä selittää osaltaan, miksi pitkät, harvinaiset yhdyssanat — suomen kielelle tyypillinen piirre — voivat toisinaan tuottaa hieman odottamattomamman vastauksen kuin lyhyet, yleiset sanat: malli käsittelee molemmat samalla mekanismilla, mutta harvinaisemmasta yhdistelmästä on ollut koulutusdatassa vähemmän esimerkkejä opittavaksi.
Sama pätee myös silloin, kun konteksti-ikkuna alkaa täyttyä pitkässä keskustelussa: malli ei laske jäljellä olevaa tilaa sanoina vaan tokeneina, joten sama merkkimäärä voi kuluttaa eri verran tilaa riippuen siitä, koostuuko teksti lyhyistä yleissanoista vai pitkistä erikoistermeistä.
Suomenkielisiä termejä tokeni, konteksti-ikkuna ja RAG ei ole erikseen suomennettu TEPA-termipankissa (“Sanaa ei löytynyt” kaikille kolmelle) — sivustolla käytetään siksi englanninkielistä termiä ja selitetään se, sen sijaan että keksittäisiin oma suomennos. Tämä ei tarkoita, että termit olisivat jotenkin epävirallisia tai väliaikaisia — ne ovat vakiintuneessa käytössä koko alalla kansainvälisesti, mutta suomenkielinen kielenhuolto ei ole vielä ottanut niihin muodollista kantaa samalla tavalla kuin vanhempiin, useammin käytettyihin käsitteisiin. Koko sanasto on koottu sivulle Tekoälysanasto, ja laajempi kuvaus siitä, miten tuottaminen etenee vaihe vaiheelta, on sivulla Miten tekoäly toimii. Kielimallien suhde muuhun generatiiviseen tekoälyyn — kuviin, videoon, ääneen — on selitetty sivulla Generatiivinen tekoäly.
Lähteet
- Tietotekniikan termitalkoot (TEPA-termipankki) — kielimalli: https://termipankki.fi/tepa/mot/mot.php?page=results&UI=figr&Opt=8&dic=1&SearchWord=kielimalli
- Kotus — “Tekoäly arvaa, sanakirja kertoo”: https://kotus.fi/tekoaly-arvaa-sanakirja-kertoo/
- Kotus — Vuoden 2024 sanapoiminnat (hallusinoida): https://kotus.fi/ajankohtaista/vuoden-sanapoiminnot/vuoden-sanapoiminnot-2024/